Integracja AI w aplikacji firmowej
Dodajemy do aplikacji funkcje oparte na dużych modelach językowych (LLM). Budujemy asystentów, którzy odpowiadają na podstawie dokumentów firmy, i funkcje, które odczytują dane z plików i porządkują zgłoszenia. Model i region dobieramy do rodzaju danych.
Gdzie AI w aplikacji oszczędza najwięcej czasu
-
Odpowiedzi ukryte w setkach dokumentów
Procedury, umowy i instrukcje leżą w różnych folderach. Asystent wyszukuje właściwe fragmenty i odpowiada na pytanie, podając dokument, z którego korzystał.
-
Dane z dokumentów przepisywane ręcznie
Model odczytuje z faktur, zamówień i formularzy potrzebne pola i zapisuje je w aplikacji. Pracownik zatwierdza wynik zamiast przepisywać całość.
-
Zgłoszenia i wiadomości do ręcznego rozdzielenia
Model rozpoznaje temat i pilność wiadomości, przypisuje ją do właściwej osoby i proponuje odpowiedź, którą pracownik może poprawić i wysłać.
-
Dane firmy nie mogą trafić do publicznego czatu
Model uruchamiamy na serwerze firmy albo w jej chmurze w UE. Gdy korzystamy z API dostawcy, wybieramy warunki, które wykluczają trenowanie modeli na Twoich danych.
Kiedy integrować AI, a kiedy wystarczy zwykły program
AI polecamy tam, gdzie dane są nieuporządkowane: tekst w dokumentach, wiadomości od klientów, pytania zadawane własnymi słowami. W takich zadaniach model językowy zastępuje pracę, której nie da się opisać prostymi regułami.
Gdy dane mają stały format, na przykład pochodzą z systemu przez API albo z formularza z polami, AI nie jest potrzebne. Wystarczy zwykła integracja systemów, która działa szybciej, taniej i zawsze tak samo. Jeśli od wyniku zależą decyzje o ludziach, pieniądzach albo zdrowiu, model może tylko przygotować propozycję, a decyzję podejmuje człowiek. Mówimy o tym otwarcie na konsultacji.
Realizacja: automatyczna weryfikacja umów z AI
- Model: najmniejszy model z rodziny Claude firmy Anthropic (Claude Haiku) w Amazon Bedrock. Na większy model można przejść bez przebudowy integracji.
- Region: AWS we Frankfurcie (eu-central-1). Dane umów nie opuszczają Unii Europejskiej.
- Skala i efekt: około 20 umów miesięcznie, średnio 30 minut oszczędności na umowę, czyli około 10 godzin pracy w miesiącu.
Dla jednego z klientów zbudowaliśmy automatyczną weryfikację umów połączoną z systemem obiegu dokumentów, którego firma już używała. Pracownicy nie zmienili sposobu pracy: umowę dodają tam, gdzie wcześniej, a raport z weryfikacji pojawia się obok niej.
- Nowa umowa w systemie obiegu dokumentów automatycznie uruchamia sprawdzenie.
- Model językowy działa w Amazon Bedrock, w regionie AWS we Frankfurcie. Treść umów nie trafia do publicznych narzędzi AI.
- Model sprawdza umowę według listy kontrolnej ustalonej z prawnikiem: strony i sposób reprezentacji, terminy, kary umowne, zasady wypowiedzenia, zakres odpowiedzialności oraz klauzule RODO i powierzenia przetwarzania danych.
- Wynikiem jest raport z oznaczonymi fragmentami umowy i opisem ryzyk przy każdym punkcie listy. Brak wymaganej klauzuli też jest oznaczony.
- Decyzję podejmuje człowiek: prawnik albo osoba odpowiedzialna za umowę. Raport skraca jej pracę, ale jej nie zastępuje.
- System zapisuje ślad: kto i kiedy uruchomił sprawdzenie, której wersji umowy dotyczył raport i kto go zatwierdził.
Jak Amazon Bedrock chroni treść umów
Bedrock wybraliśmy, bo jego zabezpieczenia są opisane w dokumentacji AWS i można je zapisać w umowie powierzenia:
- treść zapytań i odpowiedzi nie służy do trenowania modeli,
- dane są przetwarzane w regionie wybranym przy konfiguracji,
- aplikacja może łączyć się z Bedrock prywatnie, z sieci VPC przez AWS PrivateLink, bez wychodzenia do publicznego internetu,
- dane są szyfrowane w przesyle i w spoczynku,
- dostęp do modelu mają tylko usługi z odpowiednimi uprawnieniami IAM, a każde wywołanie można zapisać w logach.
Jak działa asystent AI na dokumentach firmy
- Dokumenty z wybranych folderów lub systemu trafiają do aplikacji, która dzieli je na fragmenty i zapisuje w bazie wektorowej razem z informacją o uprawnieniach.
- Pracownik zadaje pytanie w aplikacji, a ta wyszukuje fragmenty pasujące znaczeniem, także gdy pytanie używa innych słów niż dokument.
- Model językowy dostaje pytanie i znalezione fragmenty z instrukcją, by odpowiadał tylko na ich podstawie.
- Odpowiedź wraca do pracownika z odnośnikami do dokumentów źródłowych.
- Aplikacja zapisuje pytania bez odpowiedzi, co pokazuje, których dokumentów brakuje w bazie wiedzy.
Funkcję AI budujemy jako część aplikacji webowej dla firmy albo jako osobną usługę połączoną z programami, których już używasz. Modele dostępne w chmurach opisujemy na stronach aplikacje w chmurze AWS, aplikacje w Microsoft Azure i aplikacje w Google Cloud.
Co robimy
- Analizujemy proces i wskazujemy, w którym miejscu AI realnie skróci pracę
- Budujemy asystentów odpowiadających na podstawie dokumentów firmy (RAG)
- Przygotowujemy wyszukiwanie semantyczne w dokumentach i bazie wiedzy
- Odczytujemy dane z faktur, zamówień, umów i formularzy do pól aplikacji
- Sprawdzamy umowy i inne dokumenty według listy kontrolnej i oznaczamy fragmenty do weryfikacji, m.in. z modelami w Amazon Bedrock
- Uruchamiamy otwarte modele językowe na serwerze firmy, gdy dokumenty nie mogą jej opuszczać
- Klasyfikujemy zgłoszenia i wiadomości oraz przygotowujemy projekty odpowiedzi
- Dobieramy model, Claude, GPT lub Gemini, i sposób dostępu przez Amazon Bedrock, Azure OpenAI, Vertex AI albo API dostawcy
- Testujemy jakość odpowiedzi na zestawie przykładów z Twojej firmy
- Monitorujemy koszt i jakość działania AI po wdrożeniu
Dla kogo
- Pracownicy tracą czas na szukanie informacji w dokumentach firmy
- Twoja aplikacja przyjmuje dokumenty, z których dane trzeba przepisywać
- Zespół ręcznie rozdziela i odpisuje na powtarzalne wiadomości
- Chcesz wykorzystać AI, ale dane firmy nie mogą trafić do publicznych narzędzi
Asystent na dokumentach firmy (RAG)
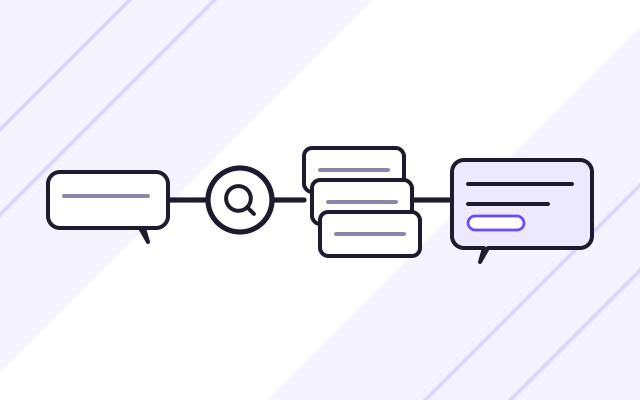
Model językowy nie zna dokumentów Twojej firmy. Dlatego dzielimy je na fragmenty, zapisujemy w bazie wektorowej i przy każdym pytaniu wyszukujemy te, które pasują. Model dostaje pytanie razem z tymi fragmentami i odpowiada wyłącznie na ich podstawie, podając źródło. Asystent uwzględnia uprawnienia: pracownik dostaje odpowiedzi tylko z dokumentów, które może czytać.
- Odpowiedzi z odnośnikiem do dokumentu źródłowego
- Uprawnienia do dokumentów przeniesione do asystenta
- Aktualizacja wiedzy po dodaniu nowego dokumentu
Odczytywanie danych z dokumentów
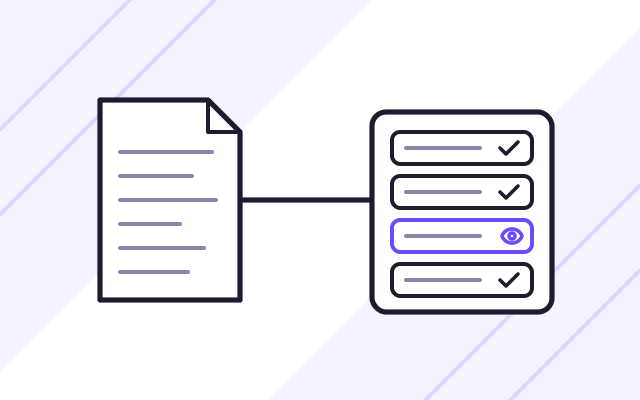
Model odczytuje z dokumentu pola, których potrzebuje aplikacja, i zwraca je w ustalonym formacie. Aplikacja sprawdza wynik regułami, na przykład czy suma pozycji zgadza się z kwotą, a pracownik zatwierdza dane przed zapisem. Pola, których model nie był pewien, oznaczamy do sprawdzenia.
- Wynik w stałym formacie, gotowy do zapisu
- Kontrola regułami i zatwierdzenie przez pracownika
- Oznaczenie pól wymagających sprawdzenia
Model, koszt i jakość pod kontrolą
Koszt modelu zależy od liczby przetwarzanych tokenów, czyli fragmentów tekstu. Prostsze zadania kierujemy do mniejszych i tańszych modeli, a trudniejsze do większych. Przed wdrożeniem przygotowujemy zestaw przykładów z Twojej firmy i mierzymy na nim jakość odpowiedzi. Ten sam zestaw sprawdzamy po każdej zmianie modelu albo instrukcji.
- Model dobrany do trudności zadania
- Pomiar jakości na przykładach z firmy
- Raport kosztu tokenów po wdrożeniu
Jak pracujemy
-
Wybór procesu
Wskazujemy zadania, w których AI skróci pracę, i ustalamy, jakie dane będą przetwarzane.
-
Prototyp na danych firmy
Budujemy prototyp na kilkudziesięciu prawdziwych przykładach i mierzymy jakość, zanim zaczniemy pełną budowę.
-
Integracja z aplikacją
Łączymy model z aplikacją, dodajemy kontrolę wyników, zatwierdzanie przez pracownika i uprawnienia.
-
Wdrożenie i pomiar
Uruchamiamy funkcję, mierzymy koszt i jakość odpowiedzi, a instrukcje dla modelu poprawiamy na podstawie wyników.
Doświadczenie
- Zbudowaliśmy dla klienta automatyczną weryfikację umów na modelu Claude w Amazon Bedrock, połączoną z jego systemem obiegu dokumentów.
Bezpieczeństwo i przepisy
-
Akt w sprawie sztucznej inteligencji (AI Act)
Rozporządzenie wprowadza obowiązki dla dostawców i użytkowników systemów AI. Osoba, która rozmawia z asystentem AI, powinna wiedzieć, że nie rozmawia z człowiekiem. Zakres obowiązków zależy od zastosowania, dlatego przy projektach w obszarach wysokiego ryzyka, np. rekrutacji, warto skonsultować się z prawnikiem.
Rozporządzenie Parlamentu Europejskiego i Rady (UE) 2024/1689 z dnia 13 czerwca 2024 r. w sprawie sztucznej inteligencji Stan prawny na
Najczęstsze pytania
Czy AI może podać błędną odpowiedź?
Tak, dlatego projektujemy funkcje AI z kontrolą. Asystent odpowiada na podstawie wskazanych dokumentów i podaje źródło, a dane odczytane z dokumentów zatwierdza pracownik. Jakość mierzymy na przykładach z Twojej firmy przed wdrożeniem i po każdej zmianie.
Czy nasze dane posłużą do trenowania modeli?
Nie. Gdy dokumenty nie mogą opuścić firmy, uruchamiamy model na Twoim serwerze. W pozostałych przypadkach korzystamy z usług, w których warunki dostawcy wykluczają trenowanie modeli na danych klienta, przez API dostawcy albo w chmurze AWS, Azure lub Google Cloud. Sposób uruchomienia i region ustalamy z Tobą przed rozpoczęciem prac.
Ile kosztuje działanie funkcji AI?
Koszt zależy od liczby i długości przetwarzanych tekstów oraz wybranego modelu. Po prototypie podajemy szacunkowy miesięczny koszt dla Twojej liczby dokumentów lub zapytań, a po wdrożeniu raportujemy faktyczne zużycie.
Czy AI można dodać do aplikacji, którą już mamy?
Tak, jeśli aplikacja ma API albo dostęp do danych, na których ma pracować model. Funkcję AI możemy zbudować jako osobną usługę połączoną z istniejącą aplikacją.
Zobacz także
-
Integracje systemów i automatyzacja procesów
Łączymy CRM, faktury, płatności online i systemy dziedzinowe, żeby dane nie były przepisywane ręcznie.
-
Aplikacje webowe dla firm
Budujemy systemy do obsługi zleceń, wycen i zamówień z osobnymi panelami dla klientów, pracowników i menedżerów.